


Anwendungsüberwachung und Protokollierung: Ein Leitfaden für Entwickler, um die Kontrolle zu übernehmen
Kein Entwickler möchte um 3 Uhr morgens dringende Serverausfälle und Warnungen zur Performance erhalten, aber genau das kann ohne eine solide Anwendungsüberwachung passieren. Schlechte Leistung und Ausfälle wirken sich direkt auf deinen Umsatz aus.
Untersuchungen von Akamai und SOASTA zeigen die brutalen wirtschaftlichen Folgen von Performance-Problemen: Schon eine Latenzsteigerung um lediglich 100 ms senkt die Konversionsraten um 7 %, während längere Ausfallzeiten stündlich Verluste in Höhe von Tausenden von Dollar verursachen können. Genau dieser direkte Zusammenhang zwischen technischer Performance und Geschäftsergebnissen ist der Grund, warum dein Überwachungssystem über die einfache Erfassung hinaus zu einem Frühwarnsystem weiterentwickelt werden muss, das Probleme erkennt und behebt, bevor sie überhaupt auf den Bildschirmen deiner Nutzer erscheinen.
Performance-Überwachung bedeutet, Probleme zu stoppen, bevor sie entstehen. Gut konfigurierte Service Level Objectives (SLOs) verwandeln potenzielle Katastrophen in kleine Korrekturen.
„Der beste Zeitpunkt, einen Fehler zu beheben, ist, bevor er überhaupt existiert.“ – Andrew Hunt, Mitautor von „The Pragmatic Programmer“
In diesem Leitfaden werden wir folgende Schlüsselbereiche beleuchten:
- Frühwarnsysteme, die Probleme bereits im Keim erkennen
- Präzise Warnmeldungen, die die Ursachen identifizieren
- Datengestützte Wartungsplanung
- Bewährte Tools, die zu deinem Stack passen
Warum überwachen? Die wahren Kosten von Ausfallzeiten
Was tut mehr weh als ein Weckruf um 3 Uhr morgens? Zu sehen, wie die Einnahmen sinken, nachdem Systeme ausgefallen sind. So verhindert intelligentes Monitoring Brände, bevor sie entstehen:
- Sieh, wie es kaputtgeht: Nutzer sagen dir nicht, wenn es langsamer wird – sie verschwinden einfach
- Schneller beheben: Präzise Einblicke in das System können deine Lösungszeit erheblich verkürzen
- Intelligente Skalierung: Überwache Kapazitätskennzahlen, um Ressourcen entsprechend dem tatsächlichen Bedarf anzupassen
- Datengestützte Entscheidungen: Miss endlich die tatsächlichen Auswirkungen deiner technischen Entscheidungen
Proaktive Sicherheit: Warte nicht, bis Sicherheitslücken auftreten. Erkenne und blockiere Bedrohungen in Echtzeit durch kontinuierliche Überwachung

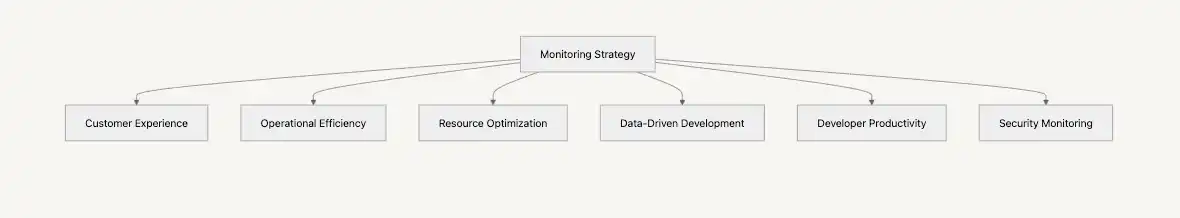
Die drei Kernelemente der Anwendungsüberwachung
Die Anwendungsüberwachung sorgt dafür, dass deine Systeme einwandfrei laufen. Drei Komponenten arbeiten zusammen, um dir zu zeigen, was unter der Haube vor sich geht.
1. Kennzahlen: Verfolge wichtige Zustandsindikatoren
- Beobachte den Zustand deines Systems in Echtzeit – erkannte kleine Störungen, bevor sie zu echten Problemen werden
- Überwache wichtige Kennzahlen wie CPU-Auslastung, Antwortzeiten und Fehlerraten
- Richte intelligente Warnmeldungen ein, die dich benachrichtigen, wenn Kennzahlen außerhalb akzeptabler Bereiche liegen
2. Protokolle: Die digitale Spur deines Systems
- Erfasse detaillierte Aufzeichnungen zu jedem wichtigen Ereignis in deiner Anwendung
- Protokolliere alles, was in deinem System passiert. Jeden Fehler, jede Warnung und jede Benutzeraktion. Das ist dein digitaler Nachweis, wenn etwas schiefgeht.
- Behebe Probleme mit vollständigen Kontext- und Zeitstempeldaten
3. Traces: Die Wegbeschreibung deiner Anfrage
- Verfolge Anfragen auf ihrem Weg durch deine verteilten Dienste
- Finde Performance-Engpässe und verbessere die Verbindungen zwischen den Diensten
- Sieh dir an, wie verschiedene Teile deiner App zusammenarbeiten – von API-Aufrufen über Datenbankabfragen bis hin zur Kommunikation zwischen Diensten
Diese drei Komponenten bilden gemeinsam die Grundlage eurer Überwachung und helfen euch, Probleme frühzeitig zu erkennen und einen reibungslosen Betrieb zu gewährleisten. Wisst ihr, was das Tolle daran ist? Moderne cloud-Plattformen haben die Einrichtung dieser Überwachungstools ziemlich einfach gemacht – das ist keine Raketenwissenschaft. Schauen wir uns im nächsten Abschnitt an, wie das geht.
Überwachung im cloud-Zeitalter
Cloud-Überwachung stellt eine direkte Verbindung zwischen dem Systemzustand und den geschäftlichen Auswirkungen her. Dank Echtzeit-Überwachung kannst du kleine Störungen erkennen und beheben, bevor sie sich zu großen Problemen ausweiten, die deine Nutzer beeinträchtigen. Du kannst dein System auf der Grundlage tatsächlicher Performance-Kennzahlen optimieren.
Moderne Container-Plattformen wie Kubernetes haben unsere Sicht auf Daten verändert und bieten detaillierte Einblicke in jede Komponente unserer Anwendungen. Du erhältst detaillierte Einblicke und behältst gleichzeitig den vollständigen Kontext deines Systems im Blick.
Multi-Runtime-Architektur: Optimierung der Überwachung über deinen gesamten Stack hinweg
Moderne Anwendungen sind vielseitig und anpassungsfähig, da sie verschiedene spezialisierte Tools (sogenannte Runtimes) nutzen, um unterschiedliche Aufgaben effizient zu erledigen. Rust übernimmt die Schwerstarbeit, Node steuert Web-APIs an und Python verarbeitet Daten. Jede Runtime benötigt ihren eigenen Überwachungsansatz, um Probleme frühzeitig zu erkennen – stell dir das so vor, als hättest du spezialisierte Ärzte für verschiedene Teile deines Systems.
| Laufzeit | Anfragen/Sek. | Speichermuster | Überwachungsschwerpunkt | Typischer Anwendungsfall |
|---|---|---|---|---|
| Rust | 690 | Statische Zuweisung | Thread-Metriken, Speichersicherheit | Hochleistungsdienste |
| Node.js | 100 | Ereignisgesteuert | Ereignisschleife, asynchrone Operationen | API-Dienste, Echtzeit-Apps |
| Python | 50 | Referenzzählung | GIL-Konflikte, Speicherverbrauch | Datenverarbeitung, ML-Dienste |
Laufzeitspezifische Überwachungsstrategien:
Diese Strategie hilft dabei, die optimale Performance in deiner gesamten Anwendung aufrechtzuerhalten und gleichzeitig die durchschnittliche Zeit bis zur Lösung zu verkürzen, wenn Probleme auftreten.
- Node.js-Überwachung
- Verfolge die Verzögerung der Ereignisschleife (Warnschwelle: >100 ms)
- Überwache Heap-Nutzungsmuster mit Tools wie clinic.js
- Beispielkonfiguration:
{ "eventLoopLag": { "warning": 100, "critical": 500 }, "heapUsage": { "warning": "70%", "critical": "85%" } }
- Python-Überwachung
- Beobachte GIL-Konflikte mit py-spy
- Speicherlecks mit memory_profiler verfolgen
- Beispielkonfiguration:
{ "gilContentionRate": { "warning": "25%", "critical": "40%" }, "memoryGrowth": { "warning": "10MB/min", "critical": "50MB/min" } }
- Rust-Überwachung
- Überwache die Auslastung des Thread-Pools, um die Reaktionsfähigkeit des Dienstes aufrechtzuerhalten
- Verwende `metrics-rs`, um Systemressourcen zu überwachen.
- Beispielkonfiguration:
{ "threadPoolUtilization": { "warning": "85%", "critical": "95%" }, "requestLatency": { "warning": "10ms", "critical": "50ms" } }
Upsun Cloud vereinfacht die Arbeit mit mehreren Laufzeiten, indem es dir von einem einzigen Ort aus Einblick in deinen gesamten Stack gewährt. Du kannst Abhängigkeiten zwischen Diensten definieren und verwalten, was dir hilft, potenzielle Engpässe zu erkennen. Mit unserer einheitlichen Überwachung kannst du die performance über alle Technologien hinweg verfolgen.
Zahlen, die Entscheidungen vorantreiben
Hier sind die wichtigsten Kennzahlen, die du im Auge behalten solltest, zusammen mit ihren Schwellenwerten und Maßnahmen für den Fall, dass etwas schiefgeht:
1. Performance-Kennzahlen (Geschwindigkeit & Reaktionszeit)
| Kennzahl | Normal | Warnung | Kritisch |
|---|---|---|---|
| Reaktionszeit | < 200 ms | > 500 ms | > 1000 ms |
| Fehlerquote | < 0,1 % | > 1 % | > 5 % |
Überwachung der Antwortzeit: Behalte die Geschwindigkeit der Antwort auf Anfragen im Blick – sie ist der Puls deiner Benutzererfahrung.
- Wenn der Warnschwellenwert erreicht wird: Analysiere langsame Abfragen (mit Datenbank-Profiling-Tools), optimiere Codepfade und überprüfe die Netzwerklatenz (mit Traceroute, MTR).
- Wenn der kritische Schwellenwert erreicht wird: Setze APM-Diagnosen ein. Verfolge Engpässe. Überprüfe Timeouts. Überwache Ressourcen.
[2025-02-13 12:15:23] [WARN] Slow query detected - Endpoint: /payment - Duration: 650ms - Query: SELECT * FROM orders WHERE user_id = ?
Überwachung der Fehlerquote: Verfolge fehlgeschlagene Anfragen, um den reibungslosen Betrieb deines Dienstes zu gewährleisten.
- Wenn der Warnschwellenwert erreicht wird: Analysiere Fehlermuster in deinem gesamten Stack (mit Tools zur Fehlerverfolgung).
- Wenn der kritische Schwellenwert erreicht wird: Überprüfe die letzten Deploys und Änderungen an der Infrastruktur.
[2025-02-13 12:30:00] [ERROR] POST /api/users - 500 Internal Server Error - Reason: Database connection failed
2. Systemkennzahlen
| Metrik | Normal | Warnung | Kritisch |
|---|---|---|---|
| CPU-Auslastung | < 70 % | > 70 % (5+ Min.) | > 85 % (2+ Min.) |
| Speicherauslastung | < 75 % | > 85 % | > 95 % |
CPU-Überwachung: Finde Performance-Engpässe frühzeitig und behebe sie, bevor deine Nutzer merken, dass etwas nicht stimmt.
- Wenn der Warnschwellenwert erreicht wird: Analysiere CPU-intensive Prozesse (mit „top“, „htop“) und optimiere Algorithmen.
- Wenn der kritische Schwellenwert erreicht wird: Skaliert die Rechenkapazität, optimiert kritische Ausführungswege.
[2025-02-13 14:20:33] [WARN] High CPU Usage - Service: API - Usage: 82%
Speicherüberwachung: Durch die Verfolgung der Speichernutzung lassen sich Speicherlecks aufspüren, bevor sie deine App zum Absturz bringen. Keine Abstürze, keine Überraschungen.
- Wenn der Warnschwellenwert erreicht wird: Führe Speicherprofiler aus, um Heap-Dumps und die Garbage Collection zu überprüfen.
- Wenn der kritische Schwellenwert erreicht wird: Spüre Speicherlecks auf und starte die Anwendung bei Bedarf neu.
[2025-02-13 14:45:10] [WARN] Memory Pressure - Service: BackgroundJobProcessor - Heap Usage: 90%
Festplatten-I/O-Überwachung: Überwache sowohl, wie schnell dein Speicher Operationen verarbeiten kann (IOPS), als auch, wie viele Daten er auf einmal übertragen kann (Durchsatz), damit alles reibungslos läuft.
- Lege Basiswerte für deine spezifischen Workloads fest (mit iostat, iotop)
- Lass dich bei signifikanten Musteränderungen benachrichtigen
- Beobachte Datenbank- und Dateioperationen genau und optimiere sie, sobald die Performance nachlässt
3. Service Level Objectives (SLOs)
Verfügbarkeitsüberwachung: Definiere messbare SLOs, die deine Service-Performance quantifizieren. Verfolge Latenz, Fehlerraten und Verfügbarkeit.
- Ziel: Strebe eine Verfügbarkeit von 99,95 % an. Verfolge das Fehlerbudget (die zulässige Anzahl an Ausfallzeiten oder Fehlern, bevor Service Level Agreements verletzt werden).
- Bei Überschreitung: Löse eine automatische Skalierung aus, sobald das Fehlerbudget 90 % erreicht, um die Kapazität proaktiv zu verwalten.
[2025-02-13 15:00:00] [LOG] SLO breach detected - Error budget: 92% - Region: US-East - Status: Initiating capacity analysis
Performance-SLOs: Lege Zielwerte für die Antwortzeit fest, die den Erwartungen der Nutzer entsprechen, und messe regelmäßig, ob diese eingehalten werden.
- Ziel: Halte die p99-Latenz (Reaktionszeit im 99. Perzentil) unter 500 ms, um sicherzustellen, dass die meisten Nutzer ein schnelles, reibungsloses Erlebnis haben.
- Bei Überschreitung: Skaliert die Ressourcen nach oben und optimiert die Codepfade, um die Service-Levels wiederherzustellen
4. Wichtige Metriken aus der Praxis
- Ladezeit der Seite:
- Normal: < 2 s
- Warnung: > 3 s
- Kritisch: > 5 s (Nutzer springen ab)
- Maßnahmen:
- Frontend-Performance analysieren (mit Lighthouse, WebPageTest)
- Assets und API-Aufrufe optimieren
- Nutze Netzwerktest-Tools, um Performance-Engpässe zu identifizieren und zu beheben
[2025-02-13 16:10:22] [WARN] Slow Page Load - URL: /products - Average Load Time: 4.2s
- Abschluss der Nutzerführung: Erfolgreiche Nutzerpfade nachverfolgen.
- Normal: > 95 %
- Warnung: < 90 %
- Kritisch: < 85 %
- Maßnahmen:
- Funnel-Analysen auswerten
- Fehlerprotokolle scannen
- Sitzungsdaten auf Abbruchpunkte überprüfen
[2025-02-13 16:30:45] [WARN] Cart Abandonment Spike - User Journey: Checkout - Completion Rate: 88%
Verfolge diese nutzerorientierten Kennzahlen konsequent und ergreife umgehend Maßnahmen, sobald Warnsignale auftreten; so sicherst du eine zuverlässige Servicebereitstellung und vermeidest Frustration bei den Nutzern. Wenn du diese Erkenntnisse mit deiner Systemüberwachung und Protokollierung kombinierst, erhältst du ein umfassendes Bild der Beobachtbarkeit, das sowohl technische Exzellenz als auch geschäftlichen Erfolg abdeckt. Auf dieser Grundlage wollen wir nun untersuchen, wie du deine Systeme mit einer robusten Sicherheitsüberwachung in Echtzeit schützen kannst.
5. Schütze deine Systeme in Echtzeit
Die Sicherheitsüberwachung arbeitet Hand in Hand mit der Performance-Überwachung, um deine Systeme vor Bedrohungen zu schützen. Hier ist dein praktisches Sicherheits-Toolkit:
- Intelligente Erkennung
- Blockiere verdächtige IP-Adressen nach 10 fehlgeschlagenen Anmeldeversuchen pro Minute
- Warnung, wenn der Datenverkehr innerhalb von 5 Minuten das Dreifache des Normalwerts überschreitet
Überprüfe Sicherheitsereignisse alle 30 Sekunden, um Angriffsmuster in Echtzeit zu erkennen – deine erste Verteidigungslinie gegen neue Bedrohungen
| Angriffstyp | Erkennungsmethode | Reaktion |
|---|---|---|
| Missbrauch von Anmeldedaten | Anmeldehäufigkeit pro IP | Progressive Ratenbegrenzung |
| Datendiebstahl | Ungewöhnliche Datenmuster | Netzwerkisolierung |
- Aktive Abwehr
- Eine Ratenbegrenzung, die sich an deine Datenverkehrsmuster anpasst
- Sofortige Blockierung böswilliger Aktivitäten
- Integration von Bedrohungsdaten in Echtzeit
- Leitfaden für schnelle Reaktionen
- Standardisierte Bedrohungsbewältigung mit MITRE ATT&CK
- Automatisierte Reaktionsabläufe
Zielwerte für die Reaktionszeit:
| Bedrohungsart | Reaktionszeit | Erforderliche Maßnahme |
|---|---|---|
| Brute-Force-Angriff | < 5 Min. | IPs sperren, Sicherheitsteam benachrichtigen |
| Datenpanne | < 15 Min. | Betroffene Systeme isolieren |
| DDoS | < 10 Min. | Abwehrmaßnahmen skalieren, Datenverkehr filtern |
| Zero-Day | < 30 Min. | Systeme patchen und aktualisieren |
6. Geschäftskennzahlen
Die technischen Kennzahlen deiner Anwendung wirken sich direkt auf deinen Gewinn aus. So wandelst du Performance-Daten in geschäftlichen Nutzen um:
| Kennzahl | Normal | Warnung | Kritisch | Maßnahme |
|---|---|---|---|---|
| Transaktion erfolgreich | ≥99 % | 98–99 % | <95 % | Zahlungssysteme und API-Verfügbarkeit prüfen |
| Umsatzverlust | 0 | 1.000–5.000 $/Std. | >10.000 $/Std. | Incident-Response aktivieren |
Reaktionsmatrix bei Transaktionsproblemen:
- 98–99 %: Engmaschig überwachen
- Systemprotokolle überprüfen
- Letzte Bereitstellungen prüfen
- 95–98 %: Sofortige Maßnahmen
- Zustand des Zahlungsgateways analysieren
- Überprüfe die Zugriffsmuster
- <95 %: Kritische Reaktion
- Das Incident-Team aktivieren
- Rollback-Verfahren durchführen
Das Wichtigste auf einen Blick: Verfolge diese Kennzahlen in Echtzeit und passe die Schwellenwerte entsprechend deinen Geschäftsabläufen an. Eine schnelle Reaktion auf Leistungseinbußen verhindert erhebliche Umsatzeinbußen.
Protokolle:
Jedes Ereignis, jeder Fehler und jede Benutzeraktion wird in Protokollen erfasst, sodass du den vollständigen Überblick hast, wenn etwas schiefgeht. Sie sind deine erste Verteidigungslinie bei Problemen in der Produktivumgebung.
Warum strukturierte Protokolle wichtig sind
- Sicherheitswarnungen: Erkenne verdächtige Muster frühzeitig
- Systemtransparenz: Sieh in Echtzeit, wie Dienste miteinander interagieren
- Früherkennung: Behebe Probleme, bevor Nutzer sie melden
Was das für dich bedeutet:
- Schnelle Suche: Probleme gezielt anhand von request_id, user_id, error_type oder timestamp eingrenzen
- Muster erkennen: Wiederkehrende Probleme erkennen, bevor sie zu Problemen werden
- Antworten automatisieren: Richte Benachrichtigungen ein, die ausgelöst werden, wenn etwas deine Aufmerksamkeit erfordert
- Saubere Daten: Analysiere Logs einheitlich über deinen gesamten Stack hinweg
Bewährte Praktiken für die Protokollierung
- Wähle deine Protokollstufen mit Bedacht aus:
DEBUG: Details nur für Entwickler (nicht in der Produktion verwenden)INFO: Normale SystemereignisseWARN: Probleme, die Aufmerksamkeit erfordernERROR: Behebbare FehlerCRITICAL: Alles stehen und liegen lassen und sofort beheben
- Wichtige Felder in jedem Protokoll:
request_id: Ereignisse dienstübergreifend verknüpfentimestamp: UTC für die globale Nachverfolgunguser_id: Wer hat das ausgelöst?service_name: Wo ist es passiert?log_level: Wie dringend ist es?
- Halte es übersichtlich: Verwende überall ein einheitliches Format
- Speichere es clever: Zentralisiere es in ELK oder im cloud-basierten Logging mit Aufbewahrungsplänen, die zu deinen Bedürfnissen passen
Beispiel: Strukturiertes Logging in Python
`import logging import json
logger = logging.getLogger(name)
def process_order(order_id, user_id, product_name, quantity): logger.info("Processing order", extra={ "order_id": order_id, "user_id": user_id, "product_name": product_name, "quantity": quantity, "event_type": "order_processing" # Adding context for analysis }) try: # ... order processing logic ... logger.info("Order processed successfully", extra={ "order_id": order_id, "status": "success", "event_type": "order_completion" }) except Exception as e: logger.error("Error processing order", extra={ "order_id": order_id, "error_message": str(e), "event_type": "order_error" }, exc_info=True) # Include stack trace for errors raise
Anwendungsbeispiel
process_order("ORD-12345", "user-42", "Awesome Widget", 2)`
Beispiel für eine Log-Ausgabe (JSON):
{"asctime": "2025-02-13 18:00:00", "levelname": "INFO", "name": "__main__", "message": "Processing order", "order_id": "ORD-12345", "user_id": "user-42", "product_name": "Awesome Widget", "quantity": 2, "event_type": "order_processing"} {"asctime": "2025-02-13 18:00:01", "levelname": "INFO", "name": "__main__", "message": "Order processed successfully", "order_id": "ORD-12345", "status": "success", "event_type": "order_completion"}
Wenn du strukturiertes Logging in anderen Programmiersprachen benötigst, findest du hier einige bewährte Optionen:
- Winston für Node.js formatiert Protokolle und leitet sie an verschiedene Ziele weiter
- Serilog für .NET bietet stark typisiertes Logging mit guter performance
- Logrus in Go hebt strukturiertes Logging mit umfangreichen Feldern und Hooks auf ein neues Niveau
Jede dieser Bibliotheken bietet eine einheitliche Möglichkeit, die Ausführung deines Programms während der Laufzeit zu erfassen.
Verteilte Tracing: Verbinde deinen Stack durchgängig
Wenn Anfragen mehrere Dienste durchlaufen, brauchst du klare Einblicke, was wo passiert. OpenTelemetry macht das einfach, indem es deine Komponenten miteinander verknüpft, sodass du Probleme schnell finden und beheben kannst.
from opentelemetry import trace
from opentelemetry.trace import Status

tracer = trace.get_tracer(__name__)

@tracer.start_as_current_span("process_order")
def process_order(order_id):
    with tracer.start_span("validate_order") as span:
        # Add business context
        span.set_attribute("order_id", order_id)

        if not is_valid(order_id):
            span.set_status(Status.ERROR)
            return False

    return True
Traces zeigen dir genau, was passiert, wenn in deinem System etwas schiefgeht, und helfen dir so, Probleme schneller zu finden und zu beheben.
Wähle die richtigen Monitoring-Tools
Deine Wahl der Überwachungstools bestimmt direkt, wie gut du Probleme erkennen und beheben kannst. Hier findest du einen übersichtlichen und praktischen Leitfaden zur Auswahl von Tools, die zu deinem Stack passen.
1. Checkliste zur Tool-Auswahl
- Wie gut kennst du dich technisch aus? Befehlszeilentools vs. einfachere Benutzeroberfläche
- Wo läuft deine App? In der cloud oder in einer Hybridumgebung?
- Wie viel kannst du ausgeben? Von open source bis Enterprise
- Was wird benötigt? Einfache Nachverfolgung oder detaillierte Einblicke
2. APM-Tools
Schnelle Einrichtung, vollständige Transparenz
- ✓ Keine Probleme bei der Einrichtung
- ✓ Sofort einsatzbereite Überwachungstools
- ✓ In wenigen Minuten mit dem Tracking loslegen
- ✓ Für Produktionslasten ausgelegt
- ✗ Mit zunehmendem Wachstum steigen die Kosten
- ✗ Schwer an spezifische Bedürfnisse anzupassen
- ✗ Du bist an die Vorgehensweise eines einzigen Anbieters gebunden
3. Eigenständige Überwachung
Für die Kontrollfreaks
- ✓ Baue es genau so auf, wie du es willst
- ✓ Unterstützt von der open source Community
- ✓ Minimiere die Kosten, indem du den Infrastruktur-Aufwand gering hältst
- ✓ Werkzeuge problemlos austauschen und ersetzen
- ✗ Erfordert fundiertes technisches Know-how
- ✗ Du bist selbst für den Monitoring-Stack verantwortlich
- ✗ Du musst die Skalierung selbst vornehmen
4. Cloud-natives Monitoring
Ideal, wenn du voll und ganz auf eine cloud setzt
- ✓ Funktioniert mit deiner Plattform
- ✓ Schnell einzurichten
- ✓ Oft in den Plattformkosten enthalten
- ✓ Ein Dashboard für alles
- ✗ An deine Plattform gebunden
- ✗ Begrenzte Anpassungsmöglichkeiten
- ✗ Features variieren je nach Plattform
Schnellvergleich
| Funktion | SaaS-APM | Open Source | Plattform-nativ |
|---|---|---|---|
| Einrichtung | Schnell (Datadog, Sentry) | Komplex (Prometheus + Grafana) | Integriert (AWS CloudWatch) |
| Steuerung | Eingeschränkt | Vollständig | Plattformbasiert |
| Skalierung | Automatisch | Manuell | Plattformgebunden |
| Kosten | Nutzungsabhängig | Infrastruktur + Wartung | In der Plattform enthalten |
| Wartung | Verwaltet | Selbstverwaltet | Plattformverwaltet |
| Integration | Vorkonfigurierte Konnektoren | Maßgeschneiderte Implementierung | Native Tools |
| Am besten geeignet für | Schnelle Bereitstellung | Völlige Flexibilität | Plattformanpassung |
Tipp: Kombiniere die Tools je nachdem, was du überwachst. Nutze SaaS-APM für die Kernkennzahlen und spezialisierte Tools für spezifische Anforderungen.
Wähle deinen Überwachungs-Stack danach aus, was dir am wichtigsten ist:
- DIY-Ansatz: Wenn du detaillierte Kontrolle und maßgeschneiderte Compliance-Features benötigst
- SaaS-APM-Tools: Wenn du eine Überwachung willst, die einfach funktioniert und mit dir mitwächst
- Cloud-native Tools: Wenn deine Apps in einer Cloud laufen und du alles integriert haben möchtest
Handlungsorientierte Überwachung: Verwandle Daten in Entscheidungen
Nachdem wir nun die Überwachungstools behandelt haben, lass uns diese Daten sinnvoll nutzen. So wandelst du Metriken in automatisierte Aktionen um:
1. Intelligente Warnmeldungen, die Maßnahmen auslösen
Konfiguriere intelligente Warnmeldungen, die Daten in Maßnahmen umsetzen:
- Auswirkungsorientiert: Konzentriere dich auf benutzer- und geschäftskritische Metriken
- Präzise Zielausrichtung: Leite Warnmeldungen sofort an die Serviceverantwortlichen weiter
- Umfassender Kontext: Füge umsetzbare Daten zur Fehlerbehebung hinzu
- Dynamische Schwellenwerte: Nutze dynamische Basiswerte, um Störsignale zu reduzieren
Vorlagen für Benachrichtigungen und Runbooks:
Reaktionszeit > 500 ms (5 Min.)
– Maßnahmen:
- check_cache_hit_ratio
- verify_db_connections
- scale_service_pods
Maßnahmen bei einer Fehlerquote > 1 % (1 Min.)
:
- inspect_error_logs
- Abhängigkeiten prüfen
- Rollback, falls nötig
Maßnahmen bei einer CPU-Auslastung > 80 % (3 Min.)
:
- Ressourcenauslastung_analysieren
- Abfragen optimieren
- Kapazität_erhöhen
Maßnahmen bei Fehlern
beim Zustandscheck:
- Endpunkte überprüfen
- Zertifikate prüfen
- restart_if_unresponsive
2. Automatisierung
Lass uns automatisierte Überwachungsworkflows implementieren:
- Alarmweiterleitung:
- Intelligentes Routing leitet kritische Probleme über PagerDuty/Slack direkt an die richtigen Teams weiter
- Automatische Eskalation von Warnmeldungen je nach Schweregrad und Reaktionszeiten
- Leite Alarmtypen über benutzerdefinierte Pfade weiter
- Problemverfolgung:
- Tickets werden automatisch mit vollständigem Kontext und Stacktrace in gerade mal 2 Sekunden erstellt
- Überwache Metriken und Verhaltenstelemetrie, um aufkommende Muster zu erkennen (Reaktionszeit unter 100 ms)
- Ressourcenskalierung:
- Automatische Skalierung basierend auf echten Performance-Daten
- Release-Kontrolle:
- Rollback von Deployments und Canary-Releases, wenn sich die Metrik in die falsche Richtung entwickelt.
# Alert configuration example
alerts:
  - name: "High API Response Time"
    metric: "http_request_duration_seconds_p95"
    threshold: 500ms
    duration: "5m"
    severity: "warning"
    route_to: "dev-team-channel"
    notification_type: "slack"

  - name: "Critical Service Down"
    metric: "service_health_check_failed"
    service: "payment-service"
    severity: "critical"
    route_to: "on-call-pager"
    notification_type: "pagerduty"
    actions:
      - "auto_restart_service"
      - "create_jira_ticket"
3. Dashboards, die den Überblick behalten
Mit Automatisierung und intelligenten Warnmeldungen erstellen wir zielgerichtete Dashboards, um wichtige Erkenntnisse zu gewinnen. Hier ist, womit wir arbeiten:
- Kernmetriken: Verfolge in Echtzeit den Systemzustand und die Performance-Metriken
- Leistungsdaten: Leistungsprobleme lokalisieren und beheben, bevor sie deine Nutzer beeinträchtigen
- Debugging-Toolkit: Tauche tief in die Kennzahlen ein, wenn etwas schiefgeht
- Rollenbasierte Ansichten: Erstelle maßgeschneiderte Dashboards, die genau auf die Bedürfnisse der einzelnen Teams zugeschnitten sind
Durch effektives Monitoring kannst du technische Probleme erkennen und beheben, bevor sie sich auf deine Nutzer auswirken.
Kostenkontrolle
- Problem: Die Überwachung wird mit zunehmendem Wachstum teurer
- Lösung: Verfolge die Kosten und optimiere die Ausgaben, indem du Kennzahlen zu Datenspeicherung und -nutzung überwachst.
Verfolge wichtige Kennzahlen:
Monatliche Kosten = (Datenpunkte × Speicherdauer) + (Protokollvolumen × Rate) + (Abfrageauslastung × Preis)
- Budgetwarnungen, die frühzeitig eingreifen
- Strenge Aufbewahrungsrichtlinien
Entwickle dein Monitoring weiter
Genau wie die Anwendungen, die sie überwachen, müssen auch Überwachungssysteme im Laufe der Zeit wachsen und sich anpassen. Statische Überwachungskonfigurationen sind schnell veraltet, wenn sich deine Architektur weiterentwickelt, neue Dienste hinzukommen und sich geschäftliche Prioritäten verschieben. Eine hervorragende Überwachung ist keine einmalige Implementierung – sie ist ein fortlaufender Prozess, der kontinuierlich immer mehr Wert liefert.
Lege einen vierteljährlichen Rhythmus fest, um deinen gesamten Observability-Ansatz zu bewerten, und prüfe dabei, welche Metriken umsetzbare Erkenntnisse liefern und welche nur Störsignale erzeugen. Dieser konsistente Überprüfungszyklus stellt sicher, dass deine Überwachungstools die Probleme erkennen, die für deine aktuelle Architektur und deine Geschäftsziele am wichtigsten sind, anstatt Probleme von gestern zu lösen.
Die ausgereiftesten Entwicklungsabteilungen behandeln ihre Überwachungskonfigurationen mit derselben Sorgfalt wie das Programmieren – sie werden versioniert, getestet und kontinuierlich verbessert. Indem du die Überwachung als lebendiges System und nicht als statische Konfiguration betrachtest, schaffst du eine Observability, die auch dann noch relevant und wertvoll bleibt, wenn sich deine technische Infrastruktur verändert.
Deine Überwachungs-Checkliste: ein praktischer Ausgangspunkt
Lass uns deine Überwachungsstrategie auf der Grundlage der Anforderungen deiner Anwendung aufbauen. Beginne mit diesen grundlegenden Schritten:
- Erfasse wichtige Nutzerabläufe. Dokumentiere deine kritischen Geschäftstransaktionen und Nutzerpfade
- Überwache Kernkennzahlen: Verfolge Antwortzeiten, CPU-Auslastung, Arbeitsspeicher und Fehler
- Füge strukturiertes Logging hinzu: Verwende JSON mit Request-IDs für die Rückverfolgung
- Richte die grundlegende Überwachung ein: Konfiguriere Verfügbarkeitsprüfungen und Tests der Nutzerreise
- Erstelle zielgerichtete Dashboards: Erstelle Ansichten, die wichtige Kennzahlen hervorheben
- Konfiguriere Warnmeldungen: Richte Benachrichtigungen ein, die zum Handeln anregen
- Überprüfen und verbessern: Plane regelmäßige Überprüfungen ein, um deine Konfiguration zu optimieren
Entwicklungsweg der Observability
Schauen wir uns an, wie sich die Überwachung weiterentwickelt, um deinen Anforderungen gerecht zu werden:
| Stufe | Überwachungsfunktion | Auswirkungen auf das Geschäft |
|---|---|---|
| 1 | Grundlegende Metriken und Protokolle | Schnellere Reaktion auf Vorfälle |
| 2 | Strukturierte Überwachung | Proaktive Problemvermeidung |
| 3 | Automatische Fehlerbehebung | 99,99 % Verfügbarkeit |
| 4 | Vorausschauende Analysen | Änderungen ohne Auswirkungen |
So funktioniert die Überwachung

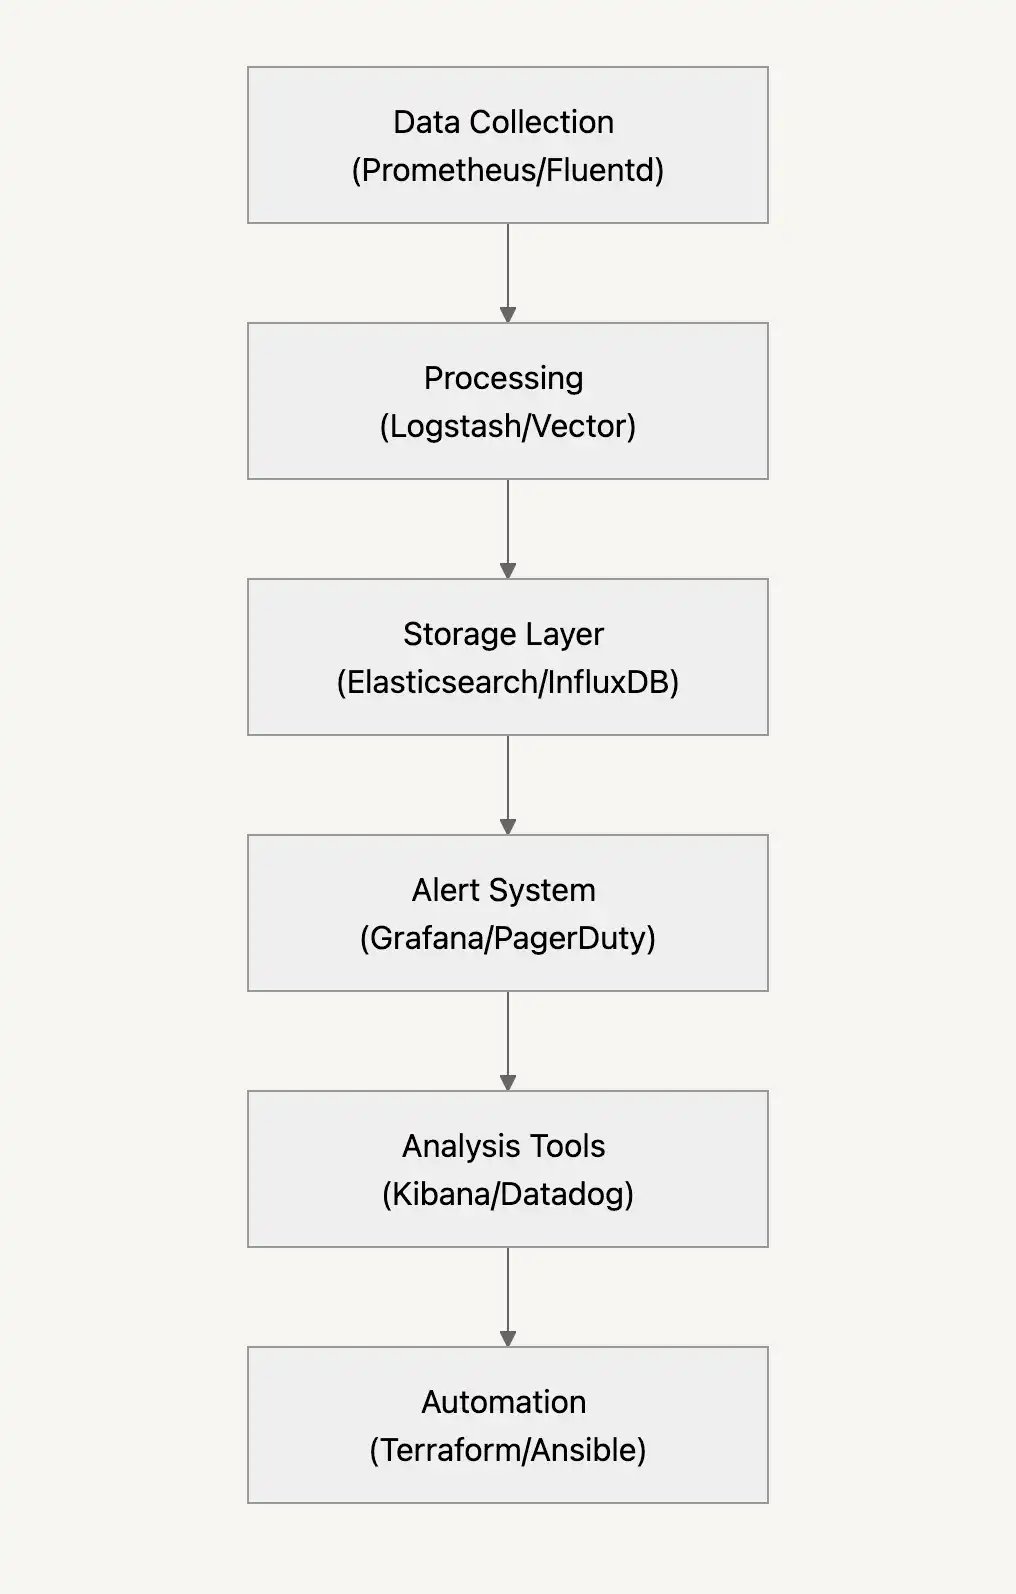
Optimiere deine Überwachungspipeline
Zuverlässige Überwachungssysteme benötigen einige Schlüsselelemente:
- Nutze intelligentes Sampling, um Daten sauber zu halten, ohne wichtige Signale zu verlieren
- Verteile die Datenlast gleichmäßig, um alle kritischen Kennzahlen zu erfassen
- Indiziere Daten für eine schnelle Problemerkennung
- Strukturiere die Daten logisch, um die Fehlerbehebung zu vereinfachen
Sicherheit
Was du bei der Überwachung von Daten beachten solltest:
- Filtere sensible Daten bereits bei der Erfassung
- Richte Aufbewahrungsrichtlinien ein, die den Compliance-Anforderungen entsprechen
- Überwache Zugriffsmuster im gesamten System
Wichtige Kennzahlen
Das solltest du im Auge behalten, damit deine Systeme gut skalieren:
- Mean Time to Recovery (MTTR): Wie schnell ihr euch von Vorfällen erholt
- Mean Time Between Failures (MTBF): Zeit zwischen Systemausfällen – je länger, desto besser
- Service Level Objectives (SLO): Eure Zuverlässigkeitsziele und -verpflichtungen
- Fehlerbudget & Burn Rate: Akzeptable Ausfallschwelle und Verbrauchsrate
Jede noch so kleine Verbesserung bringt dich einem Überwachungssystem näher, das Probleme verhindert, anstatt nur darauf zu reagieren. Baue es Schritt für Schritt auf und sieh zu, wie diese nächtlichen Warnmeldungen der Vergangenheit angehören.
Deployments leicht gemacht.
Testen Sie Upsun kostenlos.
Bleiben Sie auf dem Laufenden
Upsun Cloud: compliant and validated