


L'intégration continue et le déploiement continu (CI/CD) expliqués
Le développement logiciel moderne évolue rapidement, mais ce n'est pas le cas des processus manuels de test, de compilation et de déploiement. L’intégration continue et le déploiement continu (CI/CD) automatisent ces processus essentiels, ce qui permet aux équipes de livrer rapidement de nouvelles fonctionnalités tout en garantissant la qualité et en minimisant les problèmes en production. Alors que la CI se concentre sur le test et la compilation automatiques des modifications de code, le CD peut désigner soit la livraison continue (préparation du code pour sa mise en production), soit le déploiement continu (mise en production automatique). Comprendre cette distinction est crucial pour mettre en place la bonne stratégie pour ton équipe.
Cet article te guidera à travers les principes fondamentaux de la CI/CD, te fera découvrir des bonnes pratiques éprouvées et explorera des techniques avancées susceptibles de transformer ton processus de développement, notamment en t’expliquant comment des plateformes modernes comme Upsun Cloud peuvent améliorer ton pipeline CI/CD grâce à des environnements de test proches de la production.
Qu’est-ce que l’intégration continue (CI) ?
Le « CI » dans CI/CD signifie « intégration continue » ; cela implique l’exécution automatique de tests et la compilation du code sur un serveur distant à chaque fois que des modifications sont poussées. Ce processus garantit que le dernier commit de chaque branche passe tous les contrôles et peut être publié ou fusionné en toute sécurité dans la branche principale.
Parmi les plateformes couramment utilisées pour l’exécution de la CI, on trouve Jenkins, GitLab CI et GitHub Actions. Les exemples de cet article utilisent GitLab CI.
Le processus de CI de base comprend la vérification du style de code, l’exécution de différents types de tests et la compilation du projet. Sur GitLab CI, un tel pipeline ressemblerait à ça (en utilisant l’écosystème Node à titre d’illustration) :
# .gitlab-ci.yml
stages:  # stages are executed in strict order of the list
  - build
  - test
  - deploy

build-code:  # name of the job
  stage: build
  script:
    - npm install # install dependencies
    - npm run build # build code

code-style:
  stage: test
  script:
    - npm install # install dependencies
    - npm run lint # check code style

unit-tests:
  stage: test
  script:
    - npm install # install dependencies
    - npm run test:unit # run unit tests
L’automatisation de la vérification du code permet de gagner du temps et d’améliorer la sécurité des versions en détectant les bugs dès le début. Mais ça, c’est juste la partie visible de l’iceberg de ce que la CI peut faire. Dans les gros projets, les pipelines de CI vont souvent bien au-delà de ces trois étapes.
La mise en place d’un pipeline de CI pour une base de code complexe peut inclure les éléments suivants :
- Les processus de compilation complexes en plusieurs étapes nécessitent l’exécution de multiples actions. Par exemple, une architecture de microservices peut impliquer de compiler, tester et empaqueter plusieurs services indépendamment les uns des autres avant de les déployer ensemble.
- Exécution parallèle et distribuée des tâches. Un pipeline de CI pour un monorepo front-end et back-end peut exécuter en parallèle des analyses de linting, des tests unitaires et des vérifications de couverture de code pour chaque composant, ce qui réduit le temps total de compilation.
- Bâtissements incrémentiels. Dans les grands projets, ne reconstruire que les modules qui ont changé depuis le dernier commit peut considérablement accélérer les cycles d’itération, par exemple dans un dépôt de moteur de jeu où les ressources et la logique centrale évoluent indépendamment.
- Optimisation du temps et des ressources des processus. Utiliser des configurations de matrice de tâches pour optimiser les builds en fonction de différents environnements (par exemple, tester une API sur les versions 16, 18 et 20 de Node.js) tout en minimisant les processus redondants.
- Gestion et mise en cache des dépendances. Mise en cache efficace des dépendances volumineuses, comme les couches Docker ou les paquets npm, pour éviter de les télécharger à chaque compilation, surtout dans les environnements à bande passante limitée.
- Intégration de différents frameworks de test. Assurer une exécution fluide de Jest pour les tests unitaires, de Cypress ou Playwright pour les tests de bout en bout, et de Postman pour les tests de contrat d’API.
- Gestion des tests instables. Mise en place de stratégies de réessai lors du test d’un système de messagerie en temps réel susceptible d’échouer occasionnellement en raison de conditions de concurrence.
- Collecte et reporting des métriques. Visualiser les tendances concernant les taux de réussite des builds, la couverture des tests et les temps d’exécution du pipeline via des tableaux de bord pour identifier rapidement les goulots d’étranglement ou les régressions.
Ce ne sont là que quelques exemples. Un pipeline CI bien conçu peut être adapté pour répondre aux besoins spécifiques d’un projet, qu’il s’agisse d’améliorer les performances de compilation, la qualité du code ou la collaboration au sein de l’équipe.
C’est quoi, la livraison continue (CD) ?
Une fois que le code a été compilé et testé lors de la phase de CI, la livraison continue (CD) prend le résultat de la compilation à la sortie de l’étape d’intégration et le prépare pour la mise en production. Ça implique de déployer la compilation dans l’environnement de préproduction ou de production, d’exécuter une nouvelle série de tests de bout en bout et de télécharger le binaire dans un registre interne.
Les exemples présentés ici utilisent GitLab CI et l’écosystème Node, mais la même logique peut être mise en œuvre sur n’importe quelle plateforme CI/CD, comme Bitbucket Pipelines ou GitHub Actions.
Pour étendre l’exemple de code précédent avec la CD, tu devrais ajouter des étapes de déploiement afin de déployer la version dans l’environnement de préproduction ou de production :
stages:
  - test
  - build
  - deploy-to-staging
  - deploy-to-production

deploy-to-staging:
  stage: deploy-to-staging
  script:
    - npm install # install dependencies
    - npm run deploy:staging # deploy to staging

deploy-to-production:
  stage: deploy-to-production
  when: manual # this stage can be started only manually, if the developer wants to deploy the build to production
  script:
    - npm install # install dependencies
    - npm run deploy:production # deploy to production
Les déploiements automatisés de base, comme l’étape « deploy-to-staging » de l’exemple ci-dessus, constituent un bon point de départ pour les petits projets ou les cas d’utilisation simples. Cependant, les projets plus importants ou plus complexes nécessitent généralement des techniques supplémentaires pour renforcer la sécurité et le contrôle ; tu en apprendras davantage à ce sujet plus tard.
L’étape de déploiement en production de l’exemple est conçue pour être manuelle plutôt qu’automatisée. Le choix entre déploiements automatisés et manuels dépend de plusieurs facteurs, notamment la fréquence des versions souhaitées, la fiabilité des tests, les exigences réglementaires et les pratiques de gestion.
L’utilisation du CD et l’automatisation des processus de livraison permettent d’obtenir plus rapidement un retour d’information sur la qualité des versions, ce qui favorise des versions moins risquées et plus prévisibles.
Qu’est-ce que le déploiement continu ?
Le déploiement continu est une forme de livraison continue où toute modification de code qui passe tous les contrôles est automatiquement déployée en production. Alors que la livraison continue met l’accent sur le fait que chaque modification soit prête à être déployée, le déploiement continu va encore plus loin en supprimant complètement l’étape d’approbation manuelle.
Pour mettre en place le déploiement continu à l’aide du pipeline de la section précédente, supprime le drapeau « when: manual » de l’étape « deploy-to-production ». Si tu n’as pas besoin de déployer dans l’environnement de préproduction (en supposant que tu fasses confiance aux tests d’intégration en continu comme principale garantie de la qualité du code), tu peux aussi omettre l’étape « deploy-to-staging » :
deploy-to-production:
	stage: deploy-to-production
	script:
		- npm install # install dependencies
		- npm run deploy:production # deploy to production
Le déploiement
continu offre les mêmes avantages que la livraison continue : une réduction des tâches manuelles, une meilleure cohérence des versions et la possibilité de fournir en continu des mises à jour de haute qualité. Cependant, il nécessite des tests et une surveillance automatisés robustes, car les modifications de code sont déployées sans révision manuelle, ce qui augmente le risque de problèmes en production. Il exige également un investissement important dans l’infrastructure et les processus pour garantir la fiabilité et permettre des retours en arrière rapides si nécessaire.
Remarque : bien que la livraison continue et le déploiement continu utilisent tous deux l’acronyme « CD », la suite de cet article utilisera « CD » pour désigner le déploiement continu.
Architecture du pipeline CI/CD (pour avoir une vue d’ensemble)
Voici comment l’intégration et le déploiement continus fonctionnent généralement dans un pipeline DevOps :
- Poussée de code : le développeur pousse les modifications de code vers son dépôt VCS, GitLab, GitHub, Bitbucket, etc.
- Compilation et tests : l’intégration continue exécute automatiquement les tests et compile le code sur la plateforme CI/CD
- Déploiement : si l’étape d’intégration passe tous les contrôles, le CD déploie le code vers les environnements de préproduction ou de production
- Application en production : l’application mise à jour est désormais en ligne et accessible aux utilisateurs

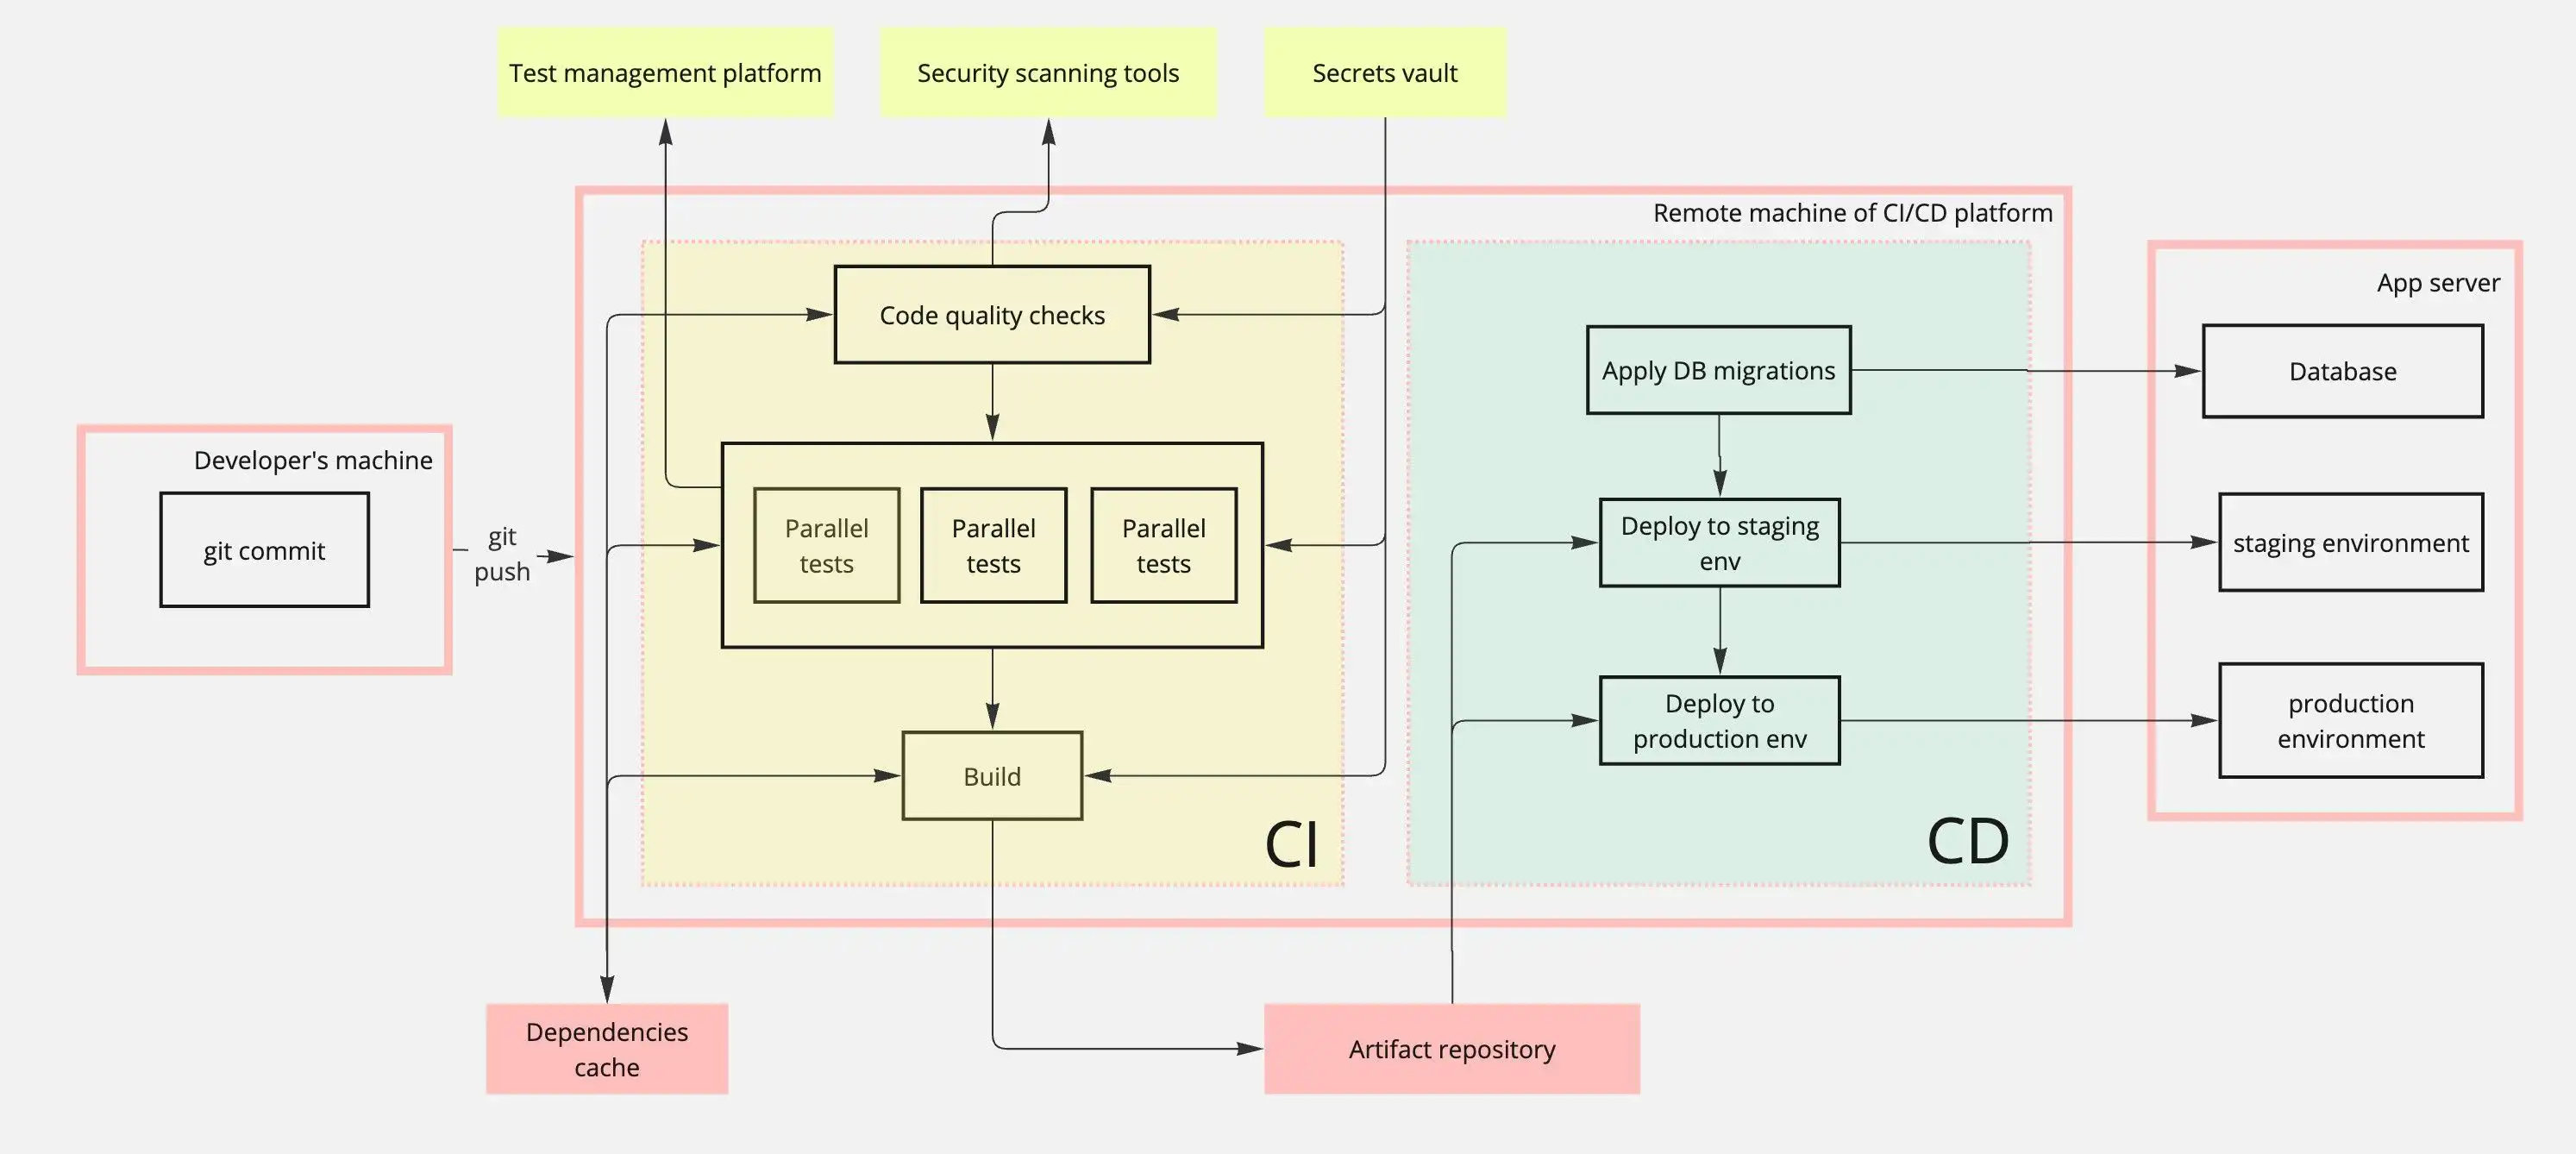
Comme tu peux le voir, un pipeline complet implique de nombreux systèmes :
En coulisses, chaque push de code déclenche :
- Des analyses de sécurité et des contrôles de qualité s'exécutent automatiquement
- Les tests s’exécutent en parallèle pour réduire au maximum le temps de compilation
- Les données sensibles (clés API, identifiants) sont intégrées en toute sécurité via la gestion des secrets
- Les dépendances sont mises en cache pour accélérer les builds suivants
- Les migrations de base de données s’appliquent automatiquement lors du déploiement
L'exécution du pipeline implique plusieurs processus parallèles :
- Des outils de sécurité statiques analysent les modifications du code à la recherche de vulnérabilités.
- Les tests s’exécutent en parallèle pour accélérer le processus.
- Les résultats des tests sont envoyés vers une plateforme de gestion des tests.
- Une fois l'artefact de build final généré, il est stocké dans le référentiel d'artefacts et déployé dans les environnements appropriés.
Ce n’est qu’un exemple de pipeline ; des composants supplémentaires peuvent être nécessaires en fonction des exigences de ton application.
Techniques avancées de CI/CD
Comme on l'a mentionné, si tu as un petit projet, un déploiement automatisé basique, comme dans l'exemple utilisé plus haut, serait un bon point de départ. Par contre, les projets plus grands ou plus complexes nécessitent généralement des techniques supplémentaires pour améliorer la sécurité et le contrôle.
Une approche consiste à utiliser des « feature flags » pour déployer du code avec des fonctionnalités masquées aux utilisateurs jusqu’à ce qu’elles soient jugées stables, ce qui permet des mises à jour incrémentielles et une annulation facile si nécessaire. Il existe différents types de « feature flags », comme les « release toggles », qui permettent un déploiement progressif des fonctionnalités, et les « experiment flags », utilisés pour les tests A/B. Par exemple, un site de e-commerce pourrait développer un nouveau filtre de recherche, mais le garder masqué derrière un « feature flag » jusqu’à ce que des tests approfondis soient terminés, pour pouvoir l’activer instantanément une fois qu’il est prêt.
Tu peux aussi utiliser des « versions canari » et des retours en arrière pour limiter les risques d'introduire des bugs, des problèmes de performances ou des impacts imprévus sur les utilisateurs lors du déploiement de nouvelles fonctionnalités. Une « version canari » consiste à déployer la mise à jour d'abord auprès d'un petit groupe d'utilisateurs. Tu peux ensuite collecter des métriques et t’assurer que la fonctionnalité fonctionne comme prévu. Si des problèmes surviennent, tu peux revenir en arrière pour ce petit groupe, ce qui rend le processus plus rapide et moins risqué. Tu peux aller encore plus loin en automatisant les retours en arrière en fonction des métriques que tu as choisies auparavant. L’automatisation te permet également d’éviter de gérer manuellement les migrations de bases de données en cas de retour en arrière. Ces techniques peuvent t’aider à effectuer des déploiements progressifs et sans heurts pour tes utilisateurs.
Les outils de surveillance et de retour d’expérience sont essentiels pour obtenir une vue d’ensemble de tes services, garantissant ainsi un déploiement sûr et permettant des retours en arrière rapides en cas de problèmes. Des outils comme Blackfire.io constituent des compléments précieux au processus de mise en production. Les indicateurs clés à surveiller comprennent les taux d’erreur, la latence des requêtes, la progression du déploiement (en particulier pour les déploiements « canary »), les taux de réussite et d’échec des « feature flags », ainsi que les indicateurs d’engagement des utilisateurs. Ces informations aident à identifier les problèmes, tels qu’une augmentation des erreurs ou l’abandon par les utilisateurs, ce qui permet de procéder à des retours en arrière si nécessaire. Les outils de surveillance permettent également de configurer des alertes et des tableaux de bord spécifiques au déploiement pour suivre les indicateurs critiques, améliorant ainsi l’observabilité et contribuant à une mise en production sûre et efficace des mises à jour.
Bonnes pratiques pour la mise en œuvre de la CI/CD
Il existe également certaines bonnes pratiques que tu peux suivre pour améliorer les processus tout en renforçant la fiabilité et la sécurité du processus CI/CD.
Automatisation des tests
L’automatisation des tests dans le CI/CD garantit que les modifications sont entièrement testées sans intervention manuelle, ce qui fait gagner du temps et réduit les risques. En suivant la pyramide des tests — avec les tests unitaires à la base, les tests d’intégration au milieu et les tests de bout en bout (E2E) au sommet —, la couverture et la vitesse sont équilibrées, ce qui permet de détecter les problèmes au bon niveau sans surcharger le pipeline.
Des éléments clés, tels que la couverture de code, les tests de mutation et la gestion des données, améliorent encore les tests CI/CD. La couverture de code permet de vérifier que les zones essentielles sont testées, tandis que les tests de mutation identifient les points faibles en vérifiant si les tests détectent des erreurs intentionnelles. La gestion des données de test à l’aide de simulacres ou d’instantanés renforce la fiabilité et la reproductibilité, améliorant ainsi la qualité globale du logiciel. Pour plus d’efficacité, l’exécution parallèle des tests, l’exécution sélective des tests concernés et l’isolation des environnements permettent d’optimiser la durée et la stabilité des tests.
Optimisations
L’optimisation des pipelines CI/CD est cruciale pour réduire au minimum le temps d’attente des développeurs et, par conséquent, déployer les modifications plus rapidement. De plus, optimiser la durée du pipeline est essentiel pour maîtriser les coûts, car la plupart des plateformes facturent en fonction du temps d’utilisation et des ressources consommées. Voici trois exemples pour t’aider à optimiser ton pipeline :
- Mise en cache des dépendances. En stockant et en réutilisant des bibliothèques ou des modules déjà téléchargés, tu peux éviter les installations redondantes, ce qui te fait gagner du temps et réduit les minutes facturables pendant l’exécution des pipelines.
- Exécuter des tâches en parallèle. Ça permet d’exécuter plusieurs vérifications en même temps, ce qui réduit considérablement les durées globales de compilation et de test. Par exemple, un grand ensemble de tests de bout en bout peut être divisé en sous-ensembles plus petits et exécuté en parallèle, ce qui accélère considérablement le processus.
- Optimisation des suites de tests. Exécute d’abord les tests critiques pour détecter rapidement les échecs et gagner du temps en évitant d’exécuter d’autres tâches si les tests échouent. L’une des techniques d’optimisation les plus efficaces consiste à mettre en place un mécanisme permettant de n’exécuter que les tests concernés par les modifications récentes.
D’autres optimisations consistent à optimiser les images Docker et à gérer efficacement les dépendances, tant au sein de la tâche d’intégration continue que celles utilisées pour la compilation.
Sécurité
Les processus CI/CD ont des exigences de sécurité spécifiques si tu veux t'assurer que le pipeline et les applications restent protégés contre les vulnérabilités. Ça implique d'adopter une approche à plusieurs niveaux pour identifier les vulnérabilités à différentes étapes du développement et du déploiement. Les tests de sécurité statiques des applications (SAST) analysent le code source ou les binaires pour identifier les failles de sécurité dès les premières phases de développement. Les tests de sécurité dynamiques des applications (DAST) analysent les applications en cours d’exécution pour détecter des problèmes tels que les attaques par injection et les failles de configuration. L’analyse de la composition logicielle (SCA) examine les dépendances et bibliothèques tierces à la recherche de vulnérabilités connues et de conformité des licences. Ces outils fonctionnent ensemble pour sécuriser les applications tout au long de leur cycle de vie, du développement au déploiement.
L’exemple de pipeline ci-dessus utilise des outils de sécurité statiques lors de l’étape de vérification de la qualité du code pour rechercher des vulnérabilités dans le code. Pour mettre en place des tests de sécurité dynamiques sur une application en cours d’exécution, tu peux configurer une tâche supplémentaire qui attend que la version soit générée, la transfère vers un environnement de test (éventuellement hébergé sur Upsun Cloud), puis exécute un outil DAST (comme OWASP Zap) pour effectuer des contrôles de sécurité dessus.
Les données sensibles, comme les clés API, doivent être stockées en toute sécurité et injectées dans les pipelines. Tu peux utiliser la gestion intégrée des secrets de ta plateforme CI/CD pour chiffrer les données stockées et les injecter en toute sécurité dans le code du pipeline. Si tu as des besoins avancés, comme la génération dynamique de clés ou un système d’autorisations flexible, tu peux envisager d’utiliser des services externes, comme HashiCorp Vault ou AWS Secrets Manager.
Si ton pipeline publie des artefacts, comme des builds ou des résultats de tests, il est important de les protéger contre tout accès non autorisé afin que personne ne puisse accéder aux informations privées générées par ton pipeline. Tu peux également ajouter une étape de scan de vulnérabilité des artefacts pour t’assurer qu’aucune donnée sensible n’a été injectée par inadvertance et qu’ils ne contiennent pas de code potentiellement malveillant.
Et ensuite ?
Cet article a exploré les concepts fondamentaux du CI/CD, les bonnes pratiques de mise en œuvre et les techniques avancées susceptibles de transformer ton processus de déploiement. Les principaux avantages du CI/CD comprennent une mise sur le marché plus rapide, une fiabilité accrue, une réduction des erreurs manuelles et la capacité à faire évoluer les processus de développement pour des projets complexes.
Mais voici le défi : même avec des pipelines CI/CD solides, les tests dans des environnements de type production restent un goulot d’étranglement. La plupart des équipes sont confrontées à des incohérences entre les environnements, à des ressources de staging limitées et à l’impossibilité de tester en toute sécurité avec des données réelles.
C’est là qu’Upsun Cloud vient renforcer tes processus CI/CD existants. Plutôt que de remplacer ta plateforme CI/CD, Upsun Cloud s’intègre parfaitement à GitHub Actions, GitLab CI, Jenkins et d’autres outils pour résoudre les défis de déploiement et de test que les pipelines ne peuvent pas résoudre à eux seuls.
Au lieu de gérer une infrastructure de déploiement complexe, ton pipeline CI/CD peut se concentrer sur ce qu’il fait le mieux, à savoir créer et tester du code, tandis qu’Upsun Cloud se charge du déploiement, de la mise à disposition des environnements et de l’hébergement de niveau production.
Prêt à améliorer ton pipeline CI/CD ? Commence ton essai gratuit d’Upsun Cloud et profite de déploiements fluides avec des environnements de test identiques à ceux de production qui s’intègrent à tes processus existants.
Déployez en toute liberté.
Essayez Upsun gratuitement.
Restez informé
Upsun Cloud: compliant and validated