


Comprendre les principes de conception des API RESTful
Les API RESTful permettent aux applications clientes d'accéder à des ressources (des données) hébergées sur un serveur distant et de les manipuler à l'aide d'un ensemble standardisé de règles et de protocoles. REST signifie « Representational State Transfer » (transfert d'état représentatif) ; il s'agit d'un ensemble de principes architecturaux qui définissent comment concevoir et mettre en œuvre ces interfaces. Les principes clés de la conception RESTful incluent l’utilisation de méthodes HTTP — comme POST, GET, PATCH et DELETE — pour effectuer des opérations CRUD (create, read, update, delete), l’identification des ressources via des URL uniques et le transfert de données dans un format léger comme JSON. Les API RESTful offrent un moyen flexible et standardisé pour que les systèmes communiquent entre eux sur Internet, ce qui en fait un élément fondamental des applications web et mobiles modernes.
Cet article aborde les principes fondamentaux de la conception d’API RESTful. À la fin, on explorera les principes clés de REST, comment ils se comparent à d’autres paradigmes, ainsi que les bonnes pratiques pour concevoir des API RESTful.
Principes de conception des API
Avant d’entrer dans les détails, voyons rapidement comment REST se compare aux autres méthodologies de conception d’API courantes.
REST
Comme mentionné, les API REST s’articulent autour de ressources (des noms) plutôt que d’actions, en utilisant les méthodes HTTP standard (GET, POST, PUT, DELETE) pour manipuler ces ressources. Les API REST s’appuient sur plusieurs principes clés pour garantir des services web cohérents et évolutifs :
- Communication sans état. Les requêtes des API REST contiennent toutes les informations nécessaires, sans qu’aucun contexte client ne soit stocké sur le serveur entre deux requêtes.
- Interface uniforme. Ce principe garantit une identification et une manipulation cohérentes des ressources grâce à des messages auto-descriptifs utilisant des en-têtes HTTP et des codes d'état standard. Il intègre également le principe HATEOAS (hypermédia comme moteur de l'état de l'application), ce qui permet aux clients de découvrir dynamiquement les capacités de l'API.
GraphQL
Créé par Facebook, GraphQL est un langage de requête et un environnement d’exécution qui permet une récupération des données plus efficace et plus flexible que les points de terminaison REST traditionnels. Ses principes de conception fondamentaux sont les suivants :
- Flexibilité des requêtes. Ça permet aux clients de préciser quelles données ils veulent dans la réponse. Du coup, on peut demander plusieurs ressources en une seule requête, tout en évitant l’overfetching et l’underfetching.
- Architecture à point de terminaison unique. Elle achemine toutes les requêtes via un seul point de terminaison, en distinguant les opérations de type « requête » (query) de celles de type « mutation ». Un schéma définit toutes les opérations et tous les types possibles au sein de l’architecture.
- Système de typage fort. Il sert de contrat entre le client et le serveur, offrant une validation de type et une documentation intégrées, tout en permettant l’utilisation d’outils de développement puissants et la vérification des types.
gRPC
Créé par Google, gRPC est un framework d’appel de procédure à distance (RPC) basé sur HTTP/2. Il fonctionne selon les principes fondamentaux suivants :
- Développement « contract-first ». Il utilise Protocol Buffers (protobuf) comme langage de définition d’interface (IDL) strict, ce qui permet la génération automatique de code pour les implémentations client et serveur.
- Prise en charge du streaming. Il inclut des capacités de streaming unaire, serveur, client et bidirectionnel, ce qui le rend efficace pour la communication en temps réel et les transferts de données volumineux, en particulier dans la communication entre microservices.
- Protocole binaire. Il utilise HTTP/2 comme couche de transport, ce qui offre une sérialisation binaire très efficace. Ça se traduit par une latence réduite et de meilleures performances par rapport aux protocoles textuels.
Aperçu des principes de conception des API
Voici un tableau qui résume certaines des différences entre ces architectures :
| REST | GraphQL | gRPC | |
| Cas d'utilisation | Idéal pour les opérations CRUD (créer, lire, mettre à jour, supprimer) et la récupération de ressources standard | Idéal pour les requêtes complexes et les situations où les clients ont besoin de données spécifiques | Idéal pour les microservices et les applications hautes performances nécessitant une communication en temps réel |
| Format des données | JSON et XML, entre autres | JSON | Protocol Buffers (binaire) |
| Style de requête | Orienté ressources (CRUD) | Orienté requêtes | Orienté procédure |
| Mise en cache | Mise en cache HTTP intégrée | Implémentation personnalisée requise | Implémentation personnalisée requise |
| Sécurité des types | Pas de sécurité des types intégrée | Système de types fort | Système de types fort |
| Gestion des erreurs | Codes d'état HTTP standard | Réponses d'erreur personnalisées via JSON | Gestion personnalisée des erreurs via Protocol Buffers |
Présentation de l'architecture d'une API RESTful
Un système utilisant une API RESTful comprend généralement trois composants clés : le client, le serveur et la base de données. Il inclut également des éléments supplémentaires tels qu’un équilibreur de charge, une mise en cache et un service d’authentification.

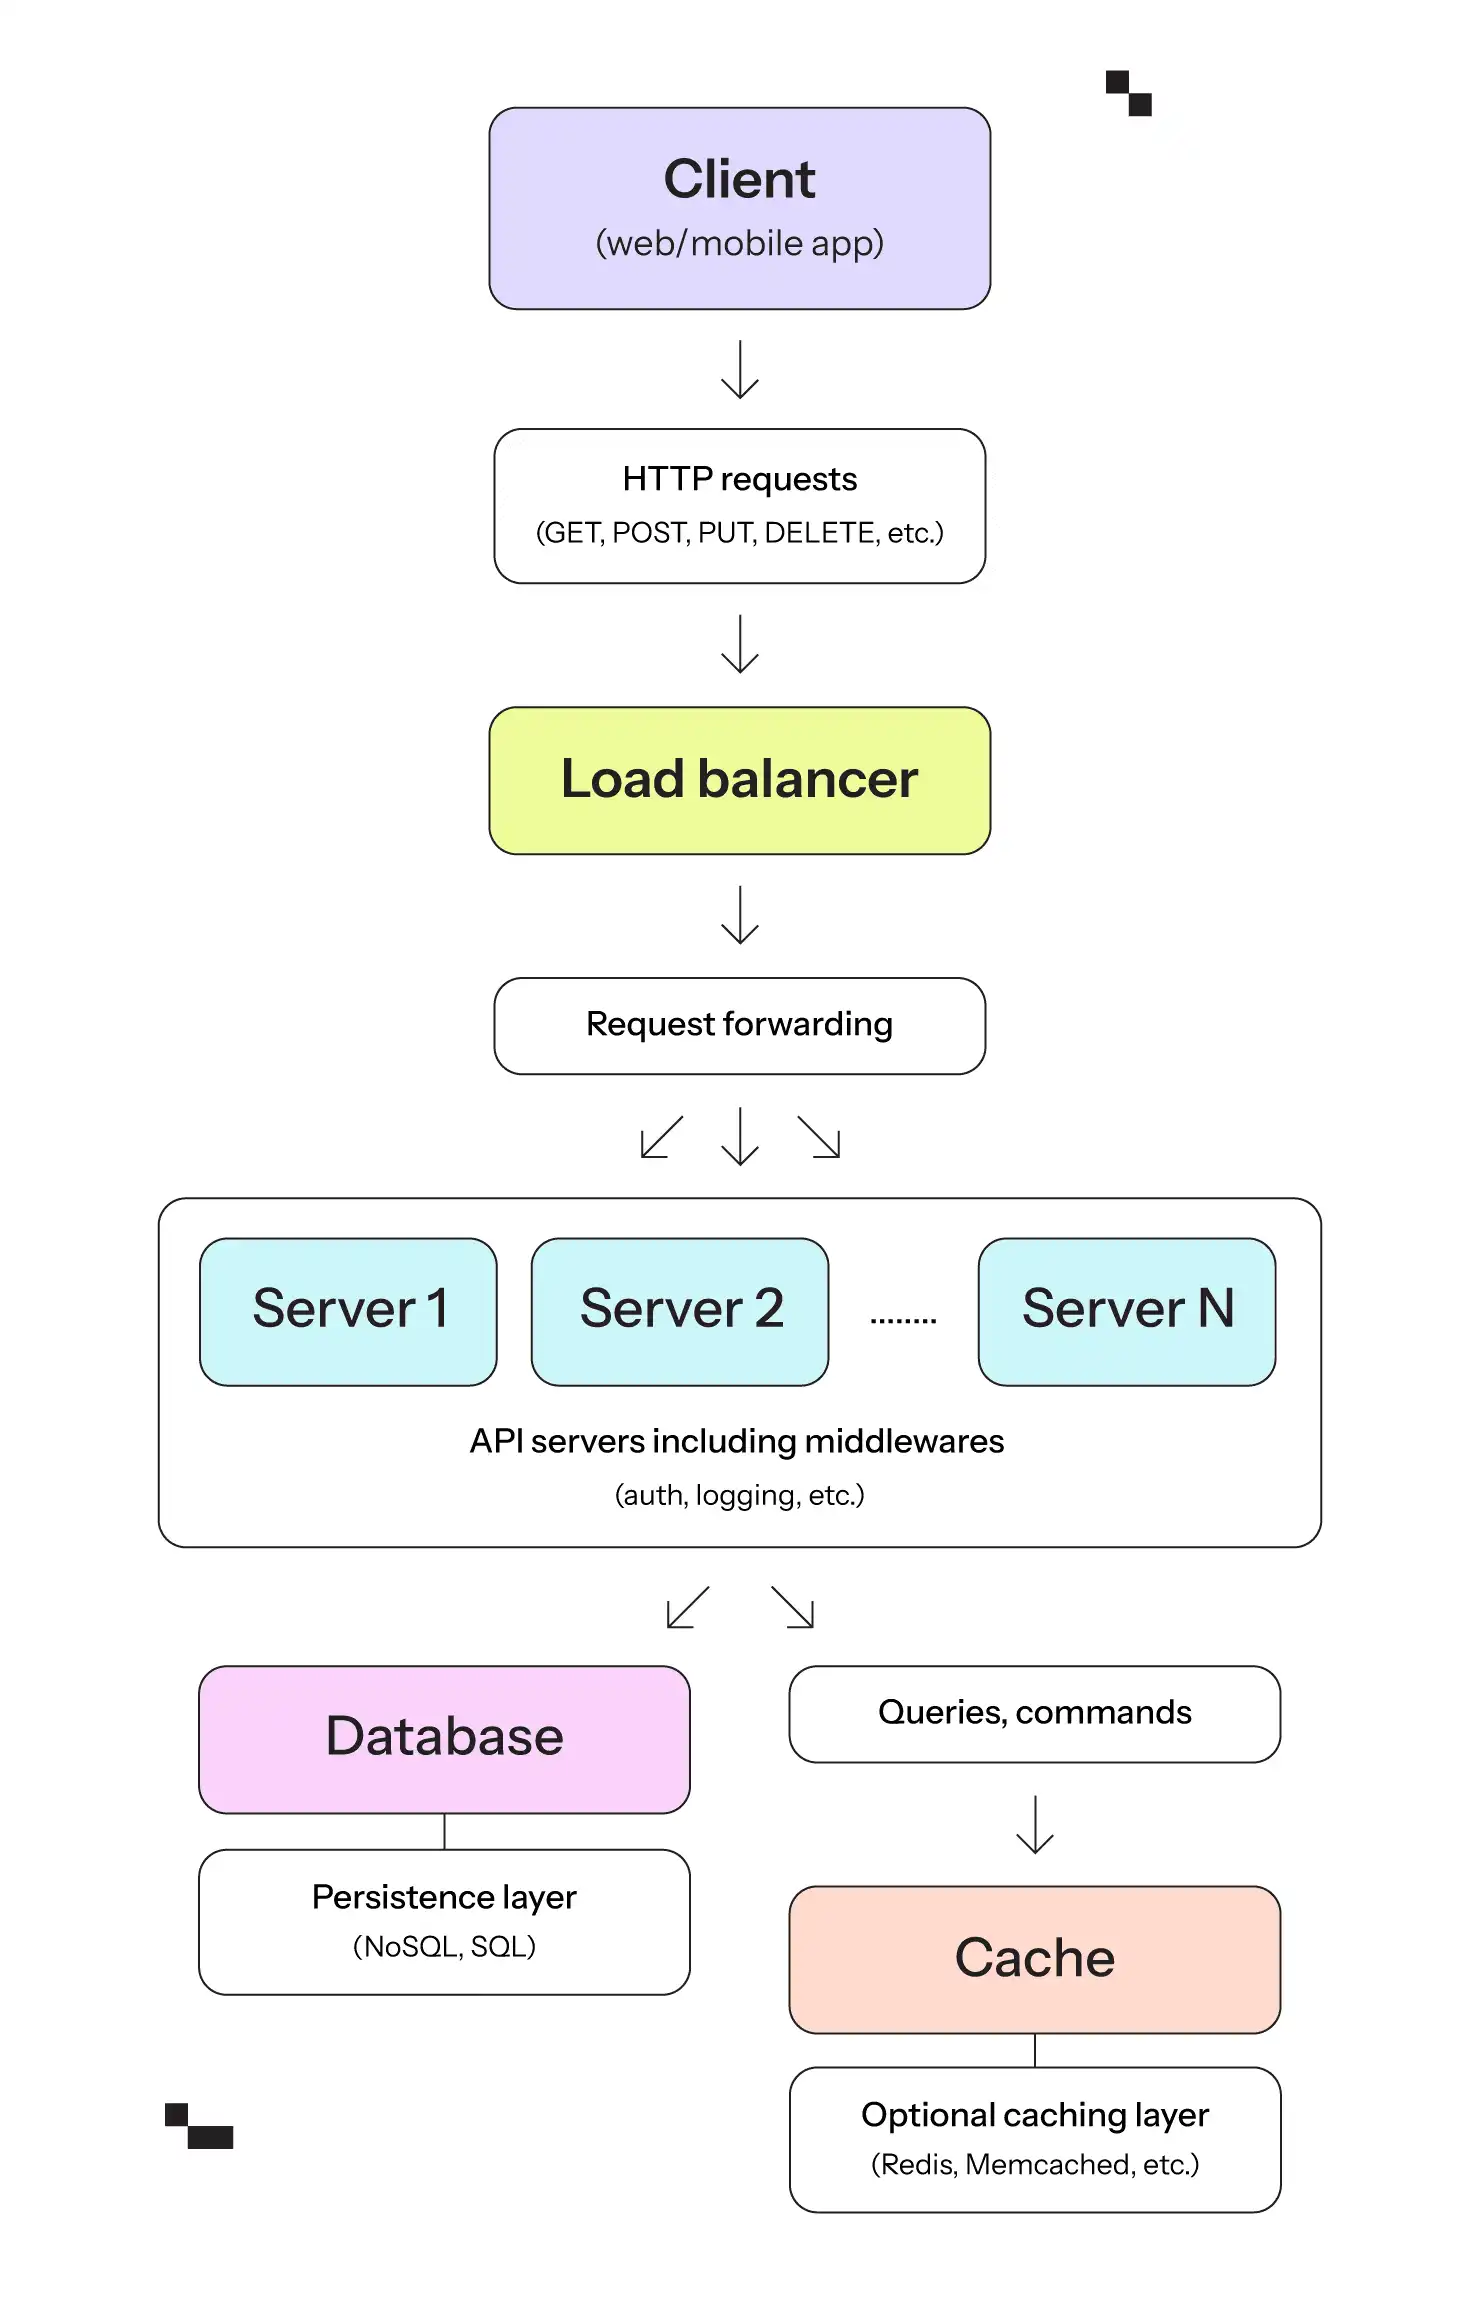
Client
Le client, c’est n’importe quelle application ou appareil qui utilise l’API. Ça peut être un navigateur web, une appli mobile ou un autre serveur dans une architecture de microservices. Les clients envoient des requêtes au serveur en utilisant des méthodes HTTP (par exemple : GET, POST, PUT, DELETE) pour effectuer des opérations CRUD sur des ressources — par exemple, une appli mobile qui récupère les données d’un utilisateur en envoyant une requête GET à https://api.example.com/users.
Serveur API
Le serveur héberge l’API et est chargé de traiter les requêtes entrantes des clients, d’interagir avec la base de données ou d’autres services, et de renvoyer des réponses. Le serveur interprète les requêtes HTTP, effectue les opérations nécessaires (comme créer, récupérer, mettre à jour ou supprimer des ressources), et renvoie les codes d’état HTTP et les données appropriés.
Le middleware constitue des couches optionnelles pouvant être intégrées à l’architecture du serveur pour gérer des fonctionnalités supplémentaires. Cela peut inclure l’authentification, la journalisation, la validation des données, la gestion des erreurs et les transformations des requêtes/réponses. Le middleware traite les requêtes avant qu’elles n’atteignent la logique centrale du serveur et peut également modifier les réponses avant qu’elles ne soient renvoyées au client.
Base de données
La base de données stocke les données de l’application. Il peut s’agir d’une base de données relationnelle (comme PostgreSQL ou MySQL), d’une base de données NoSQL (comme MongoDB) ou de toute autre forme de stockage de données. Le serveur utilise la base de données pour stocker et récupérer de manière persistante des données, telles que les informations sur les utilisateurs, les détails des produits ou l’historique des transactions.
Au sein de la base de données, une couche de mise en cache stocke des copies des données fréquemment demandées pour éviter d’avoir à accéder à la base de données à plusieurs reprises. Ça permet de réduire la latence en fournissant les données à partir du cache plutôt que d’interroger la base de données à chaque fois. On utilise souvent pour ça des bases de données en mémoire, comme Redis ou Memcached.
Équilibreur de charge
Un équilibreur de charge permet de répartir les requêtes entrantes des clients entre plusieurs instances de serveur. Ça aide à garantir une haute disponibilité et une bonne évolutivité, en évitant qu’un seul serveur ne devienne un goulot d’étranglement. Il répartit le trafic entre plusieurs instances de serveur pour améliorer les temps de réponse, assure la tolérance aux pannes en redirigeant les requêtes si un serveur ne répond plus, et peut aussi gérer la terminaison SSL pour décharger les serveurs du chiffrement et du déchiffrement.
Sur les plateformes modernes comme Upsun Cloud, cette fonctionnalité est souvent intégrée à une architecture de couche périphérique (Edge Layer) située en amont des conteneurs d’applications, qui gère le routage des requêtes, la terminaison TLS, le pare-feu WAF et l’atténuation des attaques DDoS. L’équilibrage de charge entre les instances d’application s’effectue généralement au niveau d’un proxy inverse par environnement, en aval de cette couche périphérique.
Caractéristiques clés des API REST
Les API REST reposent sur plusieurs principes fondamentaux qui définissent leur architecture et leur comportement.
Architecture client-serveur
Dans une architecture d’API RESTful, le client et le serveur fonctionnent de manière indépendante. Le client (par ex. un navigateur web ou une appli mobile) gère l’interface utilisateur et envoie les requêtes, tandis que le serveur s’occupe du traitement des données et des réponses. Cette séparation des responsabilités garantit une maintenabilité et une flexibilité à long terme.
Par exemple, une appli mobile peut interagir avec le serveur REST via son API sans avoir besoin de comprendre les détails de l’implémentation. Si l’API backend inclut du code d’interface utilisateur, ça crée un couplage étroit entre le client et le serveur, ce qui entraîne des problèmes de dépendance et rend les mises à jour plus difficiles.
Communication sans état
Comme mentionné, dans une architecture sans état, chaque requête envoyée par le client au serveur contient toutes les informations nécessaires pour traiter la requête. Le serveur ne stocke aucune donnée de session spécifique au client. Ça facilite l’évolutivité horizontale de la couche serveur de l’API. Comme chaque requête est autonome, les serveurs peuvent les traiter indépendamment, ce qui simplifie l’équilibrage de charge. Ça signifie aussi que les serveurs n’ont pas besoin de stocker l’état de la session, ce qui réduit la surcharge mémoire.
Par exemple, un appel d’API de connexion doit inclure les identifiants de l’utilisateur dans chaque requête, plutôt que de s’appuyer sur un identifiant de session stocké sur le serveur. Ça permet à n’importe quel serveur d’un cluster de traiter la requête sans avoir besoin de contexte préalable. Si un serveur s’appuie sur des données de session stockées entre les requêtes, ça complique la mise à l’échelle et rend difficile la répartition équilibrée des requêtes par les équilibreurs de charge.
Réponses pouvant être mises en cache
Les réponses des API RESTful peuvent être mises en cache, ce qui permet aux clients ou aux intermédiaires de stocker les réponses pendant un certain temps. Ça minimise le besoin de demandes répétées pour les mêmes données. Les données mises en cache peuvent être servies plus rapidement que si on interrogeait le serveur à chaque fois. Ça réduit aussi la latence et la charge du serveur, ce qui améliore l'expérience utilisateur et l'évolutivité.
Une réponse d’API peut inclure des en-têtes de mise en cache comme « Cache-Control » et « Expires », ce qui permet au client de stocker temporairement les données et d’éviter des appels inutiles au serveur. Par exemple, une réponse d’API météo pouvant être mise en cache pourrait réduire le besoin de mises à jour fréquentes si les données restent inchangées pendant une heure. Si les réponses ne comportent pas d’en-têtes de mise en cache, les clients demanderont sans cesse les mêmes données, ce qui ajoutera une charge inutile au serveur et ralentira le temps de réponse pour l’utilisateur final.
Système en couches
Un système en couches permet aux API de fonctionner à travers plusieurs couches — comme des intermédiaires, des équilibreurs de charge et des passerelles — sans que le client ait conscience de l’existence de ces couches. Cette approche offre une sécurité et une évolutivité accrues. Par exemple, les équilibreurs de charge peuvent aider à répartir le trafic sans que le client ait besoin de savoir comment la charge est équilibrée. Cette modularité facilite la mise à l’échelle ou la sécurisation de certaines parties du système sans avoir à repenser toute l’API.
Lorsqu’un client envoie une requête à une API, celle-ci peut être automatiquement acheminée via un équilibreur de charge et un pare-feu, ce qui garantit des performances et une sécurité optimisées sans modifier le code client. Si un client doit interagir directement avec plusieurs serveurs backend ou comprendre comment les requêtes sont réparties, ça ajoute de la complexité et rompt l’abstraction en couches.
Interface uniforme
Un autre principe fondamental des API REST est la contrainte d’interface uniforme, qui consiste en un ensemble de règles standard pour interagir avec l’API. Ça inclut l’utilisation cohérente des méthodes HTTP (GET, POST, PUT, DELETE), des modèles d’URL standard et des formats de réponse prévisibles. Une interface uniforme améliore la facilité d’utilisation de l’API, ce qui permet aux développeurs de mieux anticiper comment l’API va répondre aux requêtes. Cette cohérence réduit la courbe d’apprentissage et le risque d’erreurs.
Une API RESTful utilise les méthodes HTTP de manière cohérente pour toutes les ressources (par ex. GET /users récupère les utilisateurs, POST /users crée un utilisateur), ce qui garantit l’uniformité et la prévisibilité. Une API qui utilise des méthodes non standard ou qui mélange les méthodes HTTP (par ex. en utilisant GET pour créer une ressource) peut semer la confusion chez les développeurs et rendre l’API plus difficile à utiliser de manière fiable.
Code à la demande
Le « code à la demande » est une contrainte architecturale REST facultative qui permet aux serveurs d'étendre les fonctionnalités des clients en leur transmettant du code exécutable, comme du JavaScript, lors de l'exécution. Ça permet par exemple de charger des widgets dynamiques ou de mettre à jour des composants de l'interface utilisateur sans rafraîchir la page.
Ça permet au client d’étendre ses fonctionnalités de manière dynamique sans avoir à mettre à jour son code. Ça offre de la flexibilité et peut améliorer les fonctionnalités en permettant aux clients d’exécuter du code directement depuis le serveur, surtout dans les applications web dynamiques.
Conclusion
Cet article a exploré le concept des principes de conception des API RESTful ainsi que les composants essentiels qui font qu’une API est RESTful. On a commencé par un aperçu des alternatives de conception d’API et d’une topologie d’architecture système RESTful typique, suivi d’une analyse approfondie des composants clés des API RESTful. Respecter les principes de conception des API RESTful peut améliorer la qualité du code et garantir que tes API servent les utilisateurs de manière efficace et performante, ce qui contribue au succès de ton application sur le long terme.
Upsun Cloud permet aux équipes de développement modernes d’expérimenter facilement, d’itérer rapidement et d’évoluer sans effort dans toutes les dimensions. C’est une plateforme d’applications cloud en libre-service, entièrement gérée, sécurisée et axée sur les développeurs, qui offre une observabilité intégrée, une mise en cache en périphérie multicloud, un déploiement fiable et la liberté de choisir ta stack technologique et ton fournisseur de cloud. Avec Upsun Cloud, tu peux créer et exécuter des applications API RESTful en utilisant les langages de programmation et les frameworks de ton choix. Tu as un contrôle total sur la manière de faire évoluer tes applications (horizontalement ou verticalement), tandis qu’Upsun Cloud se charge des tâches les plus lourdes, notamment l’allocation des ressources et la gestion des pics de trafic.
Déployez en toute liberté.
Essayez Upsun gratuitement.
Restez informé
Upsun Cloud: compliant and validated